Diferencia entre revisiones de «Organización lógica de los datos. Estructuras dinámicas.»
(→Python) |
|||
| (No se muestran 59 ediciones intermedias del mismo usuario) | |||
| Línea 87: | Línea 87: | ||
= Estructuras Dinámicas = | = Estructuras Dinámicas = | ||
== Pilas == | == Pilas == | ||
| − | Una pila es una estructura de datos que tiene principalmente dos operaciones apilar y desapilar. Es un tipo de estructura que sigue un patrón LIFO (Last | + | === Definición === |
| + | Una pila es una estructura de datos que '''tiene principalmente dos operaciones: apilar y desapilar'''. Es un tipo de estructura que '''sigue un patrón LIFO''' (''Last In, First Out'') Es decir el último elemento que insertemos (apilar) será el primero en salir (desapilar) | ||
[[File: Estructura_Datos_Pila.PNG|center|300px| Funcionamiento de una pila]] | [[File: Estructura_Datos_Pila.PNG|center|300px| Funcionamiento de una pila]] | ||
| + | |||
| + | === Declaración === | ||
| + | #Declaración en C | ||
| + | struct tpila | ||
| + | { | ||
| + | int clave; | ||
| + | struct tpila *sig; | ||
| + | }; | ||
=== Usos === | === Usos === | ||
| Línea 189: | Línea 198: | ||
== Colas == | == Colas == | ||
| + | === Definición === | ||
Una cola es una estructura de datos que tiene principalmente dos operaciones encolar y desencolar. Es un tipo de estructura que sigue un patrón FIFO (First in, First out) Es decir el primer elemento que insertemos (encolar) será el primero en salir (desencolar). | Una cola es una estructura de datos que tiene principalmente dos operaciones encolar y desencolar. Es un tipo de estructura que sigue un patrón FIFO (First in, First out) Es decir el primer elemento que insertemos (encolar) será el primero en salir (desencolar). | ||
[[File: Estructura_Datos_Cola.PNG|center|300px| Funcionamiento de una cola]] | [[File: Estructura_Datos_Cola.PNG|center|300px| Funcionamiento de una cola]] | ||
| + | |||
| + | === Declaración === | ||
| + | # Declaración en C | ||
| + | struct tcola | ||
| + | { | ||
| + | int elems; | ||
| + | int entrada, salida; | ||
| + | int elementos[MAX_COLA]; | ||
| + | }; | ||
=== Usos === | === Usos === | ||
| Línea 236: | Línea 255: | ||
| O(1) | | O(1) | ||
|} | |} | ||
| + | |||
| + | ===== Ejemplo ===== | ||
| + | # Cremos cola. | ||
| + | # Encolamos en este orden: A, B y C | ||
| + | # Dessencolamos en este orden: A y B | ||
| + | |||
| + | <gallery> | ||
| + | File: Pila_con_lista_ligada_crear.PNG | Creamos Cola | ||
| + | File: Cola_con_lista_ligada_encolar_A.PNG | Encolamos A | ||
| + | File: Cola_con_lista_ligada_encolar_B.PNG | Encolamos B | ||
| + | File: Cola_con_lista_ligada_encolar_C.PNG | Encolamos C | ||
| + | File: Cola_con_lista_ligada_desencolar_A.PNG | Desencolamos A | ||
| + | File: Cola_con_lista_ligada_desencolar_B.PNG | Desencolamos B | ||
| + | </gallery> | ||
== Listas == | == Listas == | ||
=== Definición === | === Definición === | ||
| + | Las listas son secuencias de cero o más elementos del mismo tipo abstracto de dato. Son estructuras lineales donde cada elemento de la lista tiene un único predecesor (excepto el primero) y un único sucesor (excepto el último). | ||
| + | |||
| + | Al número de elementos de la lista se le llama longitud y decimos que la lista está vacía si tiene cero | ||
| + | elementos. | ||
| + | |||
| + | Al ser un tipo de dato dinámico, se pueden añadir nuevos elementos o suprimirlos en cualquier | ||
| + | posición. | ||
=== Declaración === | === Declaración === | ||
| + | En lenguaje mnemotécnico o pseudocódigo sería algo así: | ||
| + | <identificador>: tnodo{ | ||
| + | contenido: <tipo de objeto>; | ||
| + | siguiente: *tnodo; | ||
| + | } | ||
| + | |||
| + | Nótese que únicamente definimos un nodo con capacidad de apuntar a otro; dinámicamente iremos creando la lista reservando memoria para los nodos a medida que los necesitemos crear. | ||
=== Estructura === | === Estructura === | ||
| + | Dependiendo del tipo de lista, los elementos se enlazan mediante al menos un apuntador a la dirección de memoria del siguiente elemento. | ||
| + | Para simplificar las operaciones sobre la lista se pueden añadir un nodo vacío (sólo apuntadores, sin contenido) como cabecera de la lista y otro como cola de la lista; de esta forma las operaciones de inserción y borrado no tienen que estar comprobando estas posiciones en particular. | ||
=== Operaciones === | === Operaciones === | ||
| + | Las operaciones que se pueden realizar sobre una lista son: | ||
| + | * '''Inserción''' de un nuevo nodo | ||
| + | * '''Borrado''' de un nodo existente | ||
| + | * '''Búsqueda de un valor''' concreto | ||
| + | * '''Recorrido completo''' de la lista | ||
| + | * '''Borrado completo''' de la lista | ||
| + | * '''Comprobación''' de si es una lista vacía | ||
| + | |||
| + | === Tipos de listas === | ||
| + | ==== Listas contiguas ==== | ||
| + | Se implementan mediante vectores, y la inserción y borrado de un elemento necesitará una translación de los elementos de la lista. | ||
| + | Los elementos son adyacentes en memoria y tendrán un límite inferior y superior. | ||
| + | |||
| + | ==== Listas enlazadas ==== | ||
| + | Los elementos se colocan en posiciones de memoria que no son adyacentes, por lo que cada elemento necesitará almacenar la posición del siguiente en la lista. | ||
| + | |||
| + | <gallery> | ||
| + | File: lista_enlazada_vista_abstracta.png | Lista enlazada (vista abstracta) | ||
| + | File: lista_enlazada_vista_concreta.png | Lista enlazada (vista concreta) | ||
| + | </gallery> | ||
| + | |||
| + | Esto permite una gran versatilidad en la inserción y en el borrado de nodos, dotándolas de un gran potencial. | ||
| + | |||
| + | Normalmente se implementan de forma dinámica si el lenguaje lo permite. | ||
| + | |||
| + | ==== Listas circulares ==== | ||
| + | Consisten en una lista enlazada a la que se le añade la funcionalidad de que el último elemento apunta al primero de la lista | ||
| + | |||
| + | ==== Listas doblemente enlazadas ==== | ||
| + | En este tipo de listas cada nodo contiene dos apuntadores, uno al elemento siguiente y otro al elemento anterior. Esta implementación permite recorrer la lista en ambos sentidos. | ||
| + | |||
| + | ==== Listas doblemente enlazadas circulares ==== | ||
| + | Es una lista doblemente enlazada cuyo nodo final apunta al primero de la lista (además de al anterior por el doble enlace). | ||
| + | |||
| + | ==== Listas de listas ==== | ||
| + | También se conocen como multilista. Formado por una lista enlazada, en la que cada nodo puede apuntar además de al siguiente nodo puede apuntar a una nueva lista enlazada. | ||
== Árboles == | == Árboles == | ||
=== Definición === | === Definición === | ||
| + | Un '''árbol es un tipo abstracto de datos''' (TDA) ampliamente usado que '''imita la estructura jerárquica de las ramas un árbol''' (se representa invertido) de forma '''que existe una relación jerárquica''', y un '''único nodo principal''', denominado '''raíz''', '''precede a todos los demás''' a los que se denomina '''hijos'''. | ||
| + | |||
| + | Más formalmente, un '''árbol es un grafo conexo, acíclico y no dirigido'''. | ||
| + | |||
| + | De forma recursiva: | ||
| + | Existe un único nodo especial denominado raíz del árbol. Dicho nodo se define como el único que no tiene padre. | ||
| + | Los nodos restantes se dividen en m>=0 subconjuntos distintos: A1,A2...Am, cada uno de los cuales es a su vez un árbol y son denominados subárboles de la raíz. | ||
=== Estructura === | === Estructura === | ||
| + | La relación jerárquica existente en un árbol, se establece gráficamente mediante un arco del nodo padre a cada uno de sus hijos. | ||
| + | |||
| + | De esta forma se distinguen los siguientes tipos de nodos: | ||
| + | * Nodo raíz: El único nodo del árbol sin padre (sin ascendente) | ||
| + | * Nodo hoja: No tiene descendientes, también se conocen como nodos terminales. | ||
| + | * Nodos intermedios: Aquellos que no son ni raíz ni hoja. | ||
| + | |||
| + | En un árbol además tendremos las siguientes definiciones: | ||
| + | * Denominamos grado de un nodo al número de hijos que tiene un nodo. | ||
| + | * Longitud de camino de un nodo: número de arcos que deben ser recorridos hasta llegar a | ||
=== Tipos de árboles === | === Tipos de árboles === | ||
| + | ==== Árboles no binarios ==== | ||
| + | En este tipo de árboles cada nodo puede tener 0, 1, 2 o más hijos por nodo. | ||
| + | |||
| + | ==== Árboles binarios ==== | ||
| + | Estos árboles pueden tener como máximo dos hijos por nodo. | ||
| + | |||
| + | Los árboles binarios son más fáciles de programar que los generales. En estos es imprescindible deducir cuántas ramas o caminos se desprenden de un nodo en un momento dado. Por eso, dado que de cada subárbol binario cuelgan como máximo 2 subárboles, su programación será más | ||
| + | sencilla. | ||
| + | |||
| + | Un árbol binario se dice equilibrado si las diferencias de las alturas de los dos subárboles se diferencian en una unidad como máximo. | ||
| + | Un árbol binario de nivel h puede tener como máximo 2h-1 nodos. La altura del árbol binario lleno, de n nodos es Iog2(n+1); a la inversa, el número máximo de nodos es de (2^h)-1. | ||
| + | |||
| + | ==== Árboles binarios de búsqueda ==== | ||
| + | Un árbol binario de búsqueda es un árbol binario que se construye teniendo en cuenta tres premisas: | ||
| + | * El primer elemento se utiliza para crear el nodo raíz. | ||
| + | * Los valores del árbol deben ser tales que pueda existir un orden. | ||
| + | * En cualquier nodo, todos los valores del subárbol izquierdo del nodo son menores o iguales al valor del nodo. De modo similar, todos los valores del subárbol derecho deben ser mayores que el valor del nodo. | ||
| + | |||
| + | Los árboles binarios de búsqueda cumplen la propiedad de que al realizar un recorrido en in-orden los valores de los nodos aparecen siempre en orden creciente. Mantener el orden en el árbol recae en las operaciones de borrado e inserción. | ||
| + | |||
| + | ==== Árboles B ==== | ||
| + | Un árbol B es un árbol de búsqueda balanceado, muy utilizado en bases de datos, que no tiene porqué ser binario. Un árbol B de orden M puede tener hasta M hijos en sus nodos. | ||
| + | |||
| + | Un árbol-B se mantiene balanceado porque requiere que todos los nodos hoja se encuentren a la misma altura. | ||
| + | |||
| + | ==== Montículos ==== | ||
| + | Un montículo es una estructura de datos para almacenar valores de forma ordenada con un coste bajo. Es un tipo de árbol binario, es decir tiene un nodo y este dos hijos. | ||
| + | |||
| + | Hay dos tipos de montículos: | ||
| + | * el máximo que sería una colección de datos ordenadas de mayor a menor. en los montículos max cada hijo deberá ser menor que el padre | ||
| + | * el mínimo que sería una colección de datos ordenadas de menor a mayor. En los montículos min cada hijo deberá ser mayor que el padre . | ||
| + | |||
| + | El montículo ha de rellenarse de izquierda a derecha, sin dejar ningún nodo entre medias sin hijos. | ||
| + | |||
| + | <gallery> | ||
| + | File: Estructura_Datos_Monticulo_Minimo.PNG | Montículo mínimo | ||
| + | File: Estructura_Datos_Monticulo_Maximo.PNG | Montículo máximo | ||
| + | File: Estructura_Datos_No_Es_Monticulo.PNG | No es montículo | ||
| + | </gallery> | ||
| + | |||
| + | ===== Usos ===== | ||
| + | Nos sirve para: | ||
| + | * implementar el algoritmo de Prim | ||
| + | * implementar el algoritmo de Dijkstra | ||
| + | * tener una lista ordenada en la inserción de una forma muy rápida y eficiente | ||
| + | |||
| + | ===== Operaciones ===== | ||
| + | * Crear una cola de prioridad | ||
| + | * Insertar elemento | ||
| + | * Retirar elemento máximo / mínimo | ||
| + | * Ver el máximo / mínimo | ||
| + | * ¿Está vacío? | ||
| + | |||
| + | ===== Ordenación con heapsort ===== | ||
| + | HeapSort, es un algoritmo de ordenación que se basa en ir retirando todos los elementos de un montículo (heap) e irlo insertando por ese orden en el array: | ||
| + | |||
| + | |||
| + | Tiene un coste O(NLogN). | ||
=== Almacenamiento en memoria === | === Almacenamiento en memoria === | ||
| + | Un árbol es una estructura dinámica. Su representación en el interior de una computadora se realiza utilizando punteros. Cada nodo puede incluir varios punteros: uno para dirigirse al padre y cada uno de los restantes para dirigirse a cada uno de los hijos. Esto permite moverse con gran facilidad dentro del árbol en cualquier dirección, pero representa el inconveniente de que el número de punteros para cada nodo no es fijo y puede ser excesivamente grande. | ||
| + | |||
| + | Normalmente se utiliza otra estructura con sólo tres punteros por nodo: uno para el padre, otro para el primer hijo y el tercero para el siguiente hermano. | ||
=== Operaciones === | === Operaciones === | ||
| + | ==== Recorridos ==== | ||
| + | Una vez creado un árbol, la mayoría de las operaciones que podamos realizar sobre él, requieren conocer qué elementos tiene, por lo que hay que recorrerlos. Se denomina recorrido de un árbol al proceso que permite acceder una sola vez a cada uno de los nodos del árbol. | ||
| + | |||
| + | Existen métodos que realizan un recorrido exhaustivo del árbol y proporcionan como resultado una lista de nodos del mismo. Vamos a ver los tres más importantes: | ||
| + | ; Recorrido en Preorden | ||
| + | : Listamos la raíz del árbol y si existe, listamos el subárbol izquierdo recursivamente en preorden y a continuación si existe, el subárbol derecho recursivamente en preorden. | ||
| + | ; Recorrido en Inorden | ||
| + | : Listamos si existe el subárbol izquierdo en Inorden de forma recursiva, a continuación, listamos la raíz del árbol y seguidamente listamos en Inorden si existe el subárbol derecho recursivamente. | ||
| + | ; Recorrido en Postorden | ||
| + | : Listamos subárbol izquierdo, raíz y subárbol derecho, de forma recursiva, igual que en los recorridos anteriores. | ||
| + | |||
| + | ==== Otras operaciones ==== | ||
| + | ; Creación del árbol | ||
| + | : Inicializa el árbol al estado vacío. Dicho árbol estará definido a través del puntero que apunta al nodo superior del árbol, que inicialmente se encuentra vacío (null) | ||
| + | ; Construcción del árbol | ||
| + | : Este procedimiento irá introduciendo nodos el árbol de forma equilibrada o no según el tipo de árbol a partir de una información dada (por ejemplo, una lista) | ||
| + | ; Búsqueda de un nodo | ||
| + | : localiza el nodo con el recorrido indicado (inorden, preorden, postorden) | ||
| + | ; Inserción de un nodo | ||
| + | : primero localiza dónde insertarlo dependiendo del tipo de árbol. | ||
| + | ; Borrado de un nodo | ||
| + | : Dependiendo del tipo de nodo a insertar, si es una hoja o no, y del tipo de árbol, utilizará algoritmos diferentes, ya que en caso de no ser hoja será necesario reequilibrar el árbol. | ||
| + | |||
| + | === Usos === | ||
| + | * Representar un dato jerárquicamente | ||
| + | * Almacenar un dato de tal modo que su búsqueda sea eficiente (con la búsqueda en árboles binarios) | ||
| + | * Representar listas ordenadas de datos | ||
| + | * Como un flujo de trabajo para la composición de imágenes digitales | ||
| + | * Algoritmos de encaminamiento | ||
== Grafos == | == Grafos == | ||
| + | |||
| + | === Introducción histórica === | ||
| + | El primer artículo científico relativo a grafos fue escrito por el matemático suizo Leonhard Euler en 1736. Euler se basó en su artículo en el problema de los puentes de Königsberg. La ciudad de Kaliningrado, originalmente Königsberg, es famosa por sus siete puentes que unen ambas márgenes del río Pregel con dos de sus islas. Dos de los puentes unen la isla mayor con la margen oriental y otros dos con la margen occidental. La isla menor está conectada a cada margen por un puente y el séptimo puente une ambas islas. El problema planteaba lo siguiente: ¿es posible dar un paseo comenzando desde cualquiera de estas regiones, pasando por todos los puentes, recorriendo solo una vez cada uno y regresando al mismo punto de partida? | ||
| + | |||
| + | Abstrayendo este problema y planteándolo con la (entonces aún básica) teoría de grafos, Euler consigue demostrar que el grafo asociado al esquema de puentes de Königsberg no tiene solución, es decir, no es posible regresar al vértice de partida sin pasar por alguna arista dos veces. | ||
=== Definición === | === Definición === | ||
| + | Un grafo G {\displaystyle G} G es un par ordenado G = ( V , E ) {\displaystyle G=(V,E)} {\displaystyle G=(V,E)}, donde: | ||
| + | * V es un conjunto de vértices o nodos, y | ||
| + | * E es un conjunto de aristas o arcos, que relacionan estos nodos. | ||
| − | === Tipos de grafos === | + | Se llama '''orden del grafo G a su número de vértices''' |V|. |
| + | |||
| + | El '''grado de un vértice''' o nodo v ∈ V es igual al '''número de arcos que lo tienen como extremo'''. | ||
| + | |||
| + | Un '''camino''' es una''' secuencia de uno o más arcos que conectan dos nodos'''. La '''longitud''' de un camino es el '''número de arcos que comprende'''. | ||
| + | |||
| + | La imagen es una representación del siguiente grafo: | ||
| + | V:={1,2,3,4,5,6} | ||
| + | E:={{1,2},{1,5},{2,3},{2,5},{3,4},{4,5},{4,6}} | ||
| + | |||
| + | [[File:Grafo_Ejemplo.PNG|center|200px|Representación de grafo]] | ||
| + | |||
| + | === Tipos de grafos === | ||
| + | ==== Grafos sencillos y múltiples==== | ||
| + | Un grafo se denomina '''sencillo si no tiene lazos''', es decir, si '''no existen arcos entre el mismo elemento''' y '''no existe más que un arco para unir dos nodos'''. | ||
| + | |||
| + | Cuando un grafo no es sencillo es '''múltiple'''. | ||
| + | |||
| + | ==== Grafos dirigidos y no dirigidos==== | ||
| + | En un '''grafo dirigido''', un arco es un par ordenado de vértices (v,w) en el cual v es el extremo inicial u origen y w es el extremo final o destino del arco. El arco dirigido (v,w) se representa con una flecha que sale de v y llega a w. Se dice que w es adyacente a v, pero no al revés. La existencia del arco(v,w) no implica la existencia del arco (w,v). | ||
| + | |||
| + | En los '''grafos no dirigidos''', los vértices están relacionados, pero no se apuntan unos a otros. La dirección no es importante. Dos vértices son adyacentes si hay un arco común que los une. | ||
| + | |||
| + | Ejemplos: | ||
| + | * la '''red de aguas de una población puede ser considerada como un grafo dirigido''' ya que cada tubería sólo admite que el agua la recorra en un único sentido. | ||
| + | * la '''red de carreteras interurbanas representa un grafo no dirigido''' puesto que una misma carretera puede ser recorrida en ambos sentidos. | ||
| + | |||
| + | <gallery> | ||
| + | File: Grafo_dirigido.PNG | Grafo dirigido | ||
| + | File: Grafo_no_dirigido.PNG | Grafo no dirigido | ||
| + | </gallery> | ||
| + | |||
| + | ==== Grafos conectados y desconectados ==== | ||
| + | En los '''grafos conectados''' siempre '''existe un camino entre cualquier conjunto de vértices'''. | ||
| + | |||
| + | En los '''desconectados hay vértices que no están unidos por ningún camino'''. | ||
| + | |||
| + | ==== Grafos ponderados ==== | ||
| + | En muchas aplicaciones es útil '''asociar información a los vértices y arcos''' de un grafo dirigido. Para este propósito es posible usar un grafo dirigido etiquetado, en el cual, '''cada nodo, cada arco o ambos pueden tener una etiqueta asociada'''. Una etiqueta puede ser un nombre, un valor, un costo o cualquier tipo de datos dado. Estos grafos también se llaman '''grafos ponderados''' o con peso. | ||
=== Representación de los grafos === | === Representación de los grafos === | ||
| + | |||
| + | <gallery> | ||
| + | File: Matriz_de_adyacencia.jpg | Matriz de adyacencia | ||
| + | File: Listas_de_adyacencia.jpg | Listas de adyacencia | ||
| + | </gallery> | ||
| + | |||
| + | ==== Matriz de adyacencia ==== | ||
| + | Si G es un grafo dirigido de n nodos, el grafo G lo representaremos por una matriz N x N tal que G[i,j]=0 si no existe un arco entre el nodo i y el nodo j, y 1 (o el peso del arco en caso de tenerlo) si existe el arco. | ||
| + | |||
| + | Esta representación es tremendamente sencilla, pero tiene la limitación del uso de una estructura | ||
| + | estática de datos, por lo que el número de nodos va a estar limitado. | ||
| + | |||
| + | ==== Listas de adyacencia ==== | ||
| + | Otras representaciones más generales están basadas en la utilización de punteros. Una estructura que representa un grafo adecuadamente es una lista de listas. | ||
| + | |||
| + | En la lista principal se encuentran todos los nodos de G. Cada nodo de esta lista tiene asociada una lista auxiliar donde se indican los nodos que están conectados a él (que son adyacentes) | ||
=== Operaciones === | === Operaciones === | ||
| + | Las operaciones que puede incluir un grafo son muy variadas y dependerán del problema que queramos abordar. | ||
| + | |||
| + | Además de las clásicas de búsqueda de un elemento, inserción o eliminación de un nodo o arco, también podemos encontrarnos con: | ||
| + | * ejecución de algoritmos que busquen caminos más cortos entre dos vértices | ||
| + | * recorridos del grafo que ejecuten alguna operación sobre todos los vértices visitados, | ||
| + | * ... | ||
| + | |||
| + | = Estructuras de datos en algunos lenguajes de programación = | ||
| + | == Java == | ||
| + | Java incluye un conjunto de interfaces y clases genéricas, conocido como el Java Collection Framework (marco de trabajo de colecciones de Java), el cual contiene estructuras de datos, interfaces y algoritmos pre empaquetados para manipular estructuras de datos tales como listas, pilas, colas, conjuntos y mapas clave – valor. | ||
| + | |||
| + | <gallery> | ||
| + | File: Java%27s_java.util.Map_class_and_interface_hierarchy.PNG | Mapas | ||
| + | File: Java.util.Collection_class_and_interface_hierarchy_from_the_java.lang.Iterable_interface.PNG | Colecciones: lista, cola y conjunto | ||
| + | File: jerarquía_de_colecciones_en_java.png | Jeraraquía de colecciones (visión simplificada) | ||
| + | </gallery> | ||
| + | |||
| + | El marco de trabajo de colecciones de Java proporciona componentes reutilizables, listos para utilizarse; los programadores utilizan las estructuras de datos existentes sin tener que preocuparse por la manera en que éstas se implementan. | ||
| + | {| class="wikitable" | ||
| + | |- | ||
| + | ! Interfaz | ||
| + | ! Descripción | ||
| + | |- | ||
| + | ! Collection | ||
| + | | La interfaz raíz en la jerarquía de colecciones, a partir de la cual se derivan las interfaces Set, Queue y List. | ||
| + | |- | ||
| + | ! Set | ||
| + | | Una colección que no contiene duplicados. | ||
| + | |- | ||
| + | ! List | ||
| + | | Una colección ordenada que puede contener elementos duplicados. | ||
| + | |- | ||
| + | ! Map | ||
| + | | Asocia claves con valores y no puede contener claves duplicadas. | ||
| + | |- | ||
| + | ! Queue | ||
| + | | Por lo general, una colección del tipo primero en entrar, primero en salir, que modela a una línea de espera; pueden especificarse otros órdenes. | ||
| + | |- | ||
| + | |} | ||
| + | |||
| + | Las interfaces del marco de trabajo de colecciones declaran las operaciones que se deben realizar en forma genérica en varios tipos de colecciones | ||
| + | |||
| + | Estas clases proporcionan métodos eficientes que organizan, almacenar y recuperar sus datos sin necesidad de conocimientos de cómo se almacenan los datos. Esto reduce el tiempo de desarrollo de aplicaciones. | ||
| + | |||
| + | === Ejemplo === | ||
| + | :::<syntaxhighlight lang="java" line='line'> | ||
| + | import java.util.*; | ||
| + | public class ArrayListExample { | ||
| + | public static void main(String args[]) { | ||
| + | //Creación de una lista ArrayList de elementos de tipo String | ||
| + | ArrayList<String> lista = new ArrayList<String>(); | ||
| + | |||
| + | //Adición de elementos a la lista | ||
| + | lista.add("Juan"); | ||
| + | System.out.println("La lista actual es:"+lista); | ||
| + | } | ||
| + | } | ||
| + | </syntaxhighlight> | ||
| + | |||
| + | === Extensiones === | ||
| + | El ''framework'' Java collections se puede extender con la librería [http://commons.apache.org/proper/commons-collections/ ''Apache Commons Collections''] que añade tipos de coleciones como el mapa bidreccional, la bolsa o utilidades para crear uniones e intersecciones | ||
| + | |||
| + | Google tiene us propias librearías de ''collections'' como parte de las librerías [https://github.com/google/guava guava]. | ||
| + | |||
| + | == Python == | ||
| + | En [[Python]] hai por defecto catro tipos de datos para almacenar coleccións de datos: | ||
| + | * A '''lista''' é una colección que pode ser ordeada e cambiable; permite duplicados. | ||
| + | * A '''tupla''' é unha colección que pode ser ordeada e non cambiable; permite duplicados. | ||
| + | * O '''conxunto''' é unha colección que non pode ser ordeada nin ten un índice; non permite duplicados | ||
| + | * O '''diccionario''' é unha colección que pode ser ordeada e cambiable; non permite duplicados | ||
| + | |||
| + | É importante coñecer as propiedades de cada tipo de colección para escoller a máis axeitada, facilitando a mellor comprensión e un incremento do rendemento e da seguridade. | ||
| + | |||
| + | === Exemplos === | ||
| + | <syntaxhighlight lang="python" line='line'> | ||
| + | # exemplos | ||
| + | lista = ["pera", "banana", "cereixa"] | ||
| + | tupla = ("pera", "banana", "cereixa") | ||
| + | conxunto = {"pera", "banana", "cereixa"} | ||
| + | dicionario = { | ||
| + | "marca": "Ford", | ||
| + | "modelo": "Mustang", | ||
| + | "ano": 1965 | ||
| + | } | ||
| + | </syntaxhighlight> | ||
= Conclusiones = | = Conclusiones = | ||
| Línea 300: | Línea 639: | ||
* [https://es.wikipedia.org/wiki/Tipo_de_dato_abstracto Tipo de dato abstracto] | * [https://es.wikipedia.org/wiki/Tipo_de_dato_abstracto Tipo de dato abstracto] | ||
* [http://webdiis.unizar.es/~elvira/eda/material0304/TADespec/TAD.pdf Los Tipos Abstractos de Datos] | * [http://webdiis.unizar.es/~elvira/eda/material0304/TADespec/TAD.pdf Los Tipos Abstractos de Datos] | ||
| + | * [https://es.wikipedia.org/wiki/%C3%81rbol_(inform%C3%A1tica) Árbol] | ||
| + | * [https://openwebinars.net/academia/portada/introduccion-estructuras-datos/ Curso de introducción a las estructuras de datos] | ||
| + | |||
| + | == Java == | ||
| + | * [https://en.wikipedia.org/wiki/Java_collections_framework Java Collections Framework] | ||
| + | * [https://www.geeksforgeeks.org/vector-vs-arraylist-java/ Vector Vs Arralist en Java] | ||
| + | * [https://www.javatpoint.com/collections-in-java Collections in Java] | ||
| + | |||
| + | == Python == | ||
| + | * [https://www.w3schools.com/python/python_lists.asp Lista] | ||
| + | * [https://www.w3schools.com/python/python_tuples.asp Tupla] | ||
| + | * [https://www.w3schools.com/python/python_sets.asp Conjunto] | ||
| + | * [https://www.w3schools.com/python/python_dictionaries.asp Diccionario] | ||
| + | * [https://www.codigazo.com/python/diferencia-entre-tupla-lista-diccionario-en-python Diferencia entre tupla, lista y diccionario en Python] | ||
Revisión actual del 10:02 26 abr 2023
Sumario
- 1 Introducción
- 2 Organización Lógica de los Datos
- 3 Estructuras Dinámicas
- 4 Estructuras de datos en algunos lenguajes de programación
- 5 Conclusiones
- 6 Bibliografía
- 7 Referencias
Introducción
La información en la sociedad actual es un aspecto relevante en múltiples ramas del conocimiento; incluyendo la biología genética, la física cuántica, la divulgación científica y por supuesto la informática, Internet y el tratamiento de la información.
Cada día, se intercambian unos 2,5 billones de bytes de datos. Se estima que el 90% de los datos existentes en el mundo actual se han generado en el curso de los últimos dos años. Este diluvio se conoce como Big Data.
Sin embargo, este tremendo gigante en el que se apoya la sociedad moderna, requiere de estructuras de datos y programas que los manipulen de forma eficiente.
Según el autor Y. Daniel Liang, en su libro Introduction to Java Programming and Data Structures, Comprehensive Versión (2017), "elegir la estructura de datos más adecuada es, junto con el diseño del algoritmo, la clave para desarrollar software con un buen rendimiento".
Organización Lógica de los Datos
Descripción de datos
Un dato puede identificarse:
- de forma directa dando su valor
- asignándole un nombre con el que vamos a reconocer ese dato
Hay que ver también si ese valor va a mantener fijo su valor a lo largo del problema o bien se va a mantener constante durante todo el proceso, podemos por tanto encontrar datos literales y asociados a un identificador.
- Literales
- Es la expresión de un valor de un tipo de dato. Por ejemplo, son literales "nombre", 5, 'a'. Son, por tanto, valores fijos.
- Variables
- Representa un conjunto de posiciones de memoria que tienen asociado un nombre (identificador) y un valor (contenido) de un determinado tipo. Para utilizar una variable normalmente hay que declararla primero, asignándole un nombre y un tipo de dato.
- Constantes
- Es un dato cuyo valor se declara al principio del programa y no variará a lo largo del algoritmo. Igual que las variables se asocia un nombre al valor de la constante.
Tipos de datos
Tipos simples y compuestos
Los tipos de datos utilizados en los diferentes lenguajes de programación se pueden clasificar en tipos simples y en tipos compuestos.
Los tipos de datos simples o primitivos no están compuestos de otras estructuras de datos. Los usados más frecuentemente en casi todos los lenguajes son: enteros, reales o carácter. Los datos simples tienen como característica común que cada variable representa a un elemento.
Los tipos de datos compuestos o estructurados de datos están construidos basándose en tipos de datos simples. El ejemplo más representativo es la cadena de caracteres. Los datos estructurados tienen como característica común que un identificador puede representar a múltiples datos individuales, pudiendo estos ser referenciados individualmente.
Las estructuras de datos se pueden dividir según su modo de almacenamiento en:
- Externas
- Se almacenan en la memoria externa del ordenador: ficheros y bases de datos.
- Internas
- Se almacenan en memoria interna
Las estructuras de datos internas pueden a su vez clasificarse en:
- Estáticas
- El tamaño ocupado en la memoria se define antes de que el programa se ejecute y no puede modificarse durante la ejecución del programa. Están implementadas en casi todos los lenguajes y son los registros, ficheros y matrices. Dependiendo del tipo de dato pueden ser:
- Homogéneas
- todos los subelementos son del mismo tipo: arrays o matrices
- Heterogéneas
- los subelementos contienen datos de distintos tipos: registros
- Dinámicas
- El tamaño de la estructura se va modificando conforme avanza el programa; es decir, su tamaño cambia en tiempo de ejecución.
- Lineales
- listas, pilas, colas
- No lineales
- árboles y grafos
- Punteros
- Los tipos de datos puntero a apuntadores almacenan direcciones de memoria que a su vez indican la posición de otras estructuras de datos o funciones del programa.
El siguiente esquema muestra una clasificación de los tipos de datos más comunes:

TDA - Tipo de dato abstracto
Muy relacionado está también el concepto de tipo de dato abstracto (TDA) o Abstract Data Type que fue propuesto por primera vez hacia 1974 por John Guttag y otros, pero no fue hasta 1975 que por primera vez Barbara Liskov lo propuso para el lenguaje CLU.
Es un modelo matemático compuesto por una colección de operaciones definidas sobre un conjunto de datos para el modelo (Por ejemplo, el TDA "Cadena").
TAD = valores + operaciones
Especificación
Se debe:
- Establecer la interfaz con el usuario del tipo (“lo que necesita saber el usuario”)
- Decir qué es sin decir nada sobre cómo se hace
- Se trata de dar la lista de operaciones necesarias y especificarlas
- Debe ser precisa, legible y no ambigua

Implementación
- Elegir la representación de los valores
- Implementar las operaciones
- Debe ser estructurada, legible y eficiente
- Una propiedad deseable es la encapsulación
- Representación privada: el usuario no conoce los detalles de la implementación
- Tipo protegido: El usuario sólo puede utilizar las operaciones previstas

Ventajas y desventajas de las estructuras de datos estáticas/dinámicas
Según el autor J. Glenn Brookshear, en su libro "Introducción a la computación" (2012):
- una ventaja de las estructuras estáticas es que son más fáciles de manejar, ya que las estructuras dinámicas tienen que llevar a cabo varias tareas adicionales, como, por ejemplo, buscar bloques de memoria libres, lo que afecta al rendimiento.
- Por el contrario, las estructuras dinámicas son más versátiles, ya que no siempre se conoce previamente el número de elementos que se van a procesar.
Estructuras Dinámicas
Pilas
Definición
Una pila es una estructura de datos que tiene principalmente dos operaciones: apilar y desapilar. Es un tipo de estructura que sigue un patrón LIFO (Last In, First Out) Es decir el último elemento que insertemos (apilar) será el primero en salir (desapilar)

Declaración
#Declaración en C
struct tpila
{
 int clave;
 struct tpila *sig;
};
Usos
Algunos usos:
- Podemos implementar la acción deshacer
- Podemos implementar la búsqueda en profundidad ()
- Podemos evaluar la sintaxis de una calculadora los () y los {}
- Podemos guardar las llamadas de las funciones recursivas en el orden en que se tienen que ir ejecutando
Operaciones
- Crear una pila
- Apilar (push)
- Desapilar (pop)
- Ver la cima (peek)
- Tamaño
- ¿Está vacía?
Implementaciones
Implementación de una pila con una lista ligada
- CREAR
- Se inicializará una lista ligada.
- APILAR
- Se utilizará el método insertar al inicio
- DESAPILAR
- Se utilizará el método sacar del principio.Este método quita el elemento de la lista
- VER LA CIMA
- Se utilizará el método para ver el primer elemento de la lista ligada
| Función | Coste |
|---|---|
| Apilar | O(1) |
| Desapilar | O(1) |
| Ver la cima | O(1) |
Ejemplo
- Cremos pila.
- Apilamos en este orden: C, B y A
- Desapilamos en este orden: A

Creamos Pila

Apilamos C

Apilamos B

Apilamos A
Desapilamos A

Desapilamos B


Implementación de una pila con un Array dinámico
- CREAR
- Se iniciará un array dinámico. Puede tener un tamaño inicial por ejemplo de 5. Tendrá una variable para indicar la cima que llamaremos top y estará inicializada con -1
- APILAR
- Se utilizará la variable de tamaño para saber cual es la parte donde tiene que insertarlo
top++
arrayInterno[top] = objeto
- DESAPILAR
- Solo será necesario indicar que el top es una unidad más pequeña, para que en el siguiente apilamiento sobreescriba el dato
- VER LA CIMA
- Cogeremos el valor que este en la posicion top de del array interno
| Función | Coste |
|---|---|
| Apilar | O(1) |
| Desapilar | O(1) |
| Ver la cima | O(1) |
Ejemplo
- Creamos pila.
- Apilamos en este orden: A y B
- Desapilamos en este orden: B
Creamos pila

Apilamos A
Apilamos B

Desapilamos B


Colas
Definición
Una cola es una estructura de datos que tiene principalmente dos operaciones encolar y desencolar. Es un tipo de estructura que sigue un patrón FIFO (First in, First out) Es decir el primer elemento que insertemos (encolar) será el primero en salir (desencolar).

Declaración
# Declaración en C
struct tcola
{
 int elems;
 int entrada, salida;
 int elementos[MAX_COLA];
};
Usos
- Sirve para transferir datos entre procesos asíncronos
- En un servidor podemos implementar una cola para la venta de entradas
- Nos sirve para implementar la búsqueda en anchura
Operaciones
- Crear una cola
- Encolar (Enqueue)
- Desencolar (Dequeue)
- Ver el frente (peek)
- Tamaño
- ¿Está vacía?
Implementación con una lista ligada
Implementación de una pila con una lista ligada
- CREAR
- Se inicializará una lista ligada.
- ENCOLAR
- Se utilizará el método insertar al final
- DESENCOLAR
- Se utilizará el método sacar al principio. Este método quita el elemento de la cola
- VER EL FRENTE
- Se utilizará el método para ver el primer elemento de la lista ligada
| Función | Coste |
|---|---|
| Encolar | O(1) |
| Desencolar | O(1) |
| Ver el frente | O(1) |
Ejemplo
- Cremos cola.
- Encolamos en este orden: A, B y C
- Dessencolamos en este orden: A y B
Creamos Cola

Encolamos A

Encolamos B

Encolamos C

Desencolamos A

Desencolamos B


Listas
Definición
Las listas son secuencias de cero o más elementos del mismo tipo abstracto de dato. Son estructuras lineales donde cada elemento de la lista tiene un único predecesor (excepto el primero) y un único sucesor (excepto el último).
Al número de elementos de la lista se le llama longitud y decimos que la lista está vacía si tiene cero elementos.
Al ser un tipo de dato dinámico, se pueden añadir nuevos elementos o suprimirlos en cualquier posición.
Declaración
En lenguaje mnemotécnico o pseudocódigo sería algo así:
<identificador>: tnodo{
   contenido: <tipo de objeto>;
   siguiente: *tnodo;
}
Nótese que únicamente definimos un nodo con capacidad de apuntar a otro; dinámicamente iremos creando la lista reservando memoria para los nodos a medida que los necesitemos crear.
Estructura
Dependiendo del tipo de lista, los elementos se enlazan mediante al menos un apuntador a la dirección de memoria del siguiente elemento. Para simplificar las operaciones sobre la lista se pueden añadir un nodo vacío (sólo apuntadores, sin contenido) como cabecera de la lista y otro como cola de la lista; de esta forma las operaciones de inserción y borrado no tienen que estar comprobando estas posiciones en particular.
Operaciones
Las operaciones que se pueden realizar sobre una lista son:
- Inserción de un nuevo nodo
- Borrado de un nodo existente
- Búsqueda de un valor concreto
- Recorrido completo de la lista
- Borrado completo de la lista
- Comprobación de si es una lista vacía
Tipos de listas
Listas contiguas
Se implementan mediante vectores, y la inserción y borrado de un elemento necesitará una translación de los elementos de la lista. Los elementos son adyacentes en memoria y tendrán un límite inferior y superior.
Listas enlazadas
Los elementos se colocan en posiciones de memoria que no son adyacentes, por lo que cada elemento necesitará almacenar la posición del siguiente en la lista.
Lista enlazada (vista abstracta)
Lista enlazada (vista concreta)


Esto permite una gran versatilidad en la inserción y en el borrado de nodos, dotándolas de un gran potencial.
Normalmente se implementan de forma dinámica si el lenguaje lo permite.
Listas circulares
Consisten en una lista enlazada a la que se le añade la funcionalidad de que el último elemento apunta al primero de la lista
Listas doblemente enlazadas
En este tipo de listas cada nodo contiene dos apuntadores, uno al elemento siguiente y otro al elemento anterior. Esta implementación permite recorrer la lista en ambos sentidos.
Listas doblemente enlazadas circulares
Es una lista doblemente enlazada cuyo nodo final apunta al primero de la lista (además de al anterior por el doble enlace).
Listas de listas
También se conocen como multilista. Formado por una lista enlazada, en la que cada nodo puede apuntar además de al siguiente nodo puede apuntar a una nueva lista enlazada.
Árboles
Definición
Un árbol es un tipo abstracto de datos (TDA) ampliamente usado que imita la estructura jerárquica de las ramas un árbol (se representa invertido) de forma que existe una relación jerárquica, y un único nodo principal, denominado raíz, precede a todos los demás a los que se denomina hijos.
Más formalmente, un árbol es un grafo conexo, acíclico y no dirigido.
De forma recursiva: Existe un único nodo especial denominado raíz del árbol. Dicho nodo se define como el único que no tiene padre. Los nodos restantes se dividen en m>=0 subconjuntos distintos: A1,A2...Am, cada uno de los cuales es a su vez un árbol y son denominados subárboles de la raíz.
Estructura
La relación jerárquica existente en un árbol, se establece gráficamente mediante un arco del nodo padre a cada uno de sus hijos.
De esta forma se distinguen los siguientes tipos de nodos:
- Nodo raíz: El único nodo del árbol sin padre (sin ascendente)
- Nodo hoja: No tiene descendientes, también se conocen como nodos terminales.
- Nodos intermedios: Aquellos que no son ni raíz ni hoja.
En un árbol además tendremos las siguientes definiciones:
- Denominamos grado de un nodo al número de hijos que tiene un nodo.
- Longitud de camino de un nodo: número de arcos que deben ser recorridos hasta llegar a
Tipos de árboles
Árboles no binarios
En este tipo de árboles cada nodo puede tener 0, 1, 2 o más hijos por nodo.
Árboles binarios
Estos árboles pueden tener como máximo dos hijos por nodo.
Los árboles binarios son más fáciles de programar que los generales. En estos es imprescindible deducir cuántas ramas o caminos se desprenden de un nodo en un momento dado. Por eso, dado que de cada subárbol binario cuelgan como máximo 2 subárboles, su programación será más sencilla.
Un árbol binario se dice equilibrado si las diferencias de las alturas de los dos subárboles se diferencian en una unidad como máximo. Un árbol binario de nivel h puede tener como máximo 2h-1 nodos. La altura del árbol binario lleno, de n nodos es Iog2(n+1); a la inversa, el número máximo de nodos es de (2^h)-1.
Árboles binarios de búsqueda
Un árbol binario de búsqueda es un árbol binario que se construye teniendo en cuenta tres premisas:
- El primer elemento se utiliza para crear el nodo raíz.
- Los valores del árbol deben ser tales que pueda existir un orden.
- En cualquier nodo, todos los valores del subárbol izquierdo del nodo son menores o iguales al valor del nodo. De modo similar, todos los valores del subárbol derecho deben ser mayores que el valor del nodo.
Los árboles binarios de búsqueda cumplen la propiedad de que al realizar un recorrido en in-orden los valores de los nodos aparecen siempre en orden creciente. Mantener el orden en el árbol recae en las operaciones de borrado e inserción.
Árboles B
Un árbol B es un árbol de búsqueda balanceado, muy utilizado en bases de datos, que no tiene porqué ser binario. Un árbol B de orden M puede tener hasta M hijos en sus nodos.
Un árbol-B se mantiene balanceado porque requiere que todos los nodos hoja se encuentren a la misma altura.
Montículos
Un montículo es una estructura de datos para almacenar valores de forma ordenada con un coste bajo. Es un tipo de árbol binario, es decir tiene un nodo y este dos hijos.
Hay dos tipos de montículos:
- el máximo que sería una colección de datos ordenadas de mayor a menor. en los montículos max cada hijo deberá ser menor que el padre
- el mínimo que sería una colección de datos ordenadas de menor a mayor. En los montículos min cada hijo deberá ser mayor que el padre .
El montículo ha de rellenarse de izquierda a derecha, sin dejar ningún nodo entre medias sin hijos.
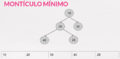
Montículo mínimo
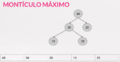
Montículo máximo
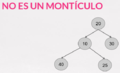
No es montículo


Usos
Nos sirve para:
- implementar el algoritmo de Prim
- implementar el algoritmo de Dijkstra
- tener una lista ordenada en la inserción de una forma muy rápida y eficiente
Operaciones
- Crear una cola de prioridad
- Insertar elemento
- Retirar elemento máximo / mínimo
- Ver el máximo / mínimo
- ¿Está vacío?
Ordenación con heapsort
HeapSort, es un algoritmo de ordenación que se basa en ir retirando todos los elementos de un montículo (heap) e irlo insertando por ese orden en el array:
Tiene un coste O(NLogN).
Almacenamiento en memoria
Un árbol es una estructura dinámica. Su representación en el interior de una computadora se realiza utilizando punteros. Cada nodo puede incluir varios punteros: uno para dirigirse al padre y cada uno de los restantes para dirigirse a cada uno de los hijos. Esto permite moverse con gran facilidad dentro del árbol en cualquier dirección, pero representa el inconveniente de que el número de punteros para cada nodo no es fijo y puede ser excesivamente grande.
Normalmente se utiliza otra estructura con sólo tres punteros por nodo: uno para el padre, otro para el primer hijo y el tercero para el siguiente hermano.
Operaciones
Recorridos
Una vez creado un árbol, la mayoría de las operaciones que podamos realizar sobre él, requieren conocer qué elementos tiene, por lo que hay que recorrerlos. Se denomina recorrido de un árbol al proceso que permite acceder una sola vez a cada uno de los nodos del árbol.
Existen métodos que realizan un recorrido exhaustivo del árbol y proporcionan como resultado una lista de nodos del mismo. Vamos a ver los tres más importantes:
- Recorrido en Preorden
- Listamos la raíz del árbol y si existe, listamos el subárbol izquierdo recursivamente en preorden y a continuación si existe, el subárbol derecho recursivamente en preorden.
- Recorrido en Inorden
- Listamos si existe el subárbol izquierdo en Inorden de forma recursiva, a continuación, listamos la raíz del árbol y seguidamente listamos en Inorden si existe el subárbol derecho recursivamente.
- Recorrido en Postorden
- Listamos subárbol izquierdo, raíz y subárbol derecho, de forma recursiva, igual que en los recorridos anteriores.
Otras operaciones
- Creación del árbol
- Inicializa el árbol al estado vacío. Dicho árbol estará definido a través del puntero que apunta al nodo superior del árbol, que inicialmente se encuentra vacío (null)
- Construcción del árbol
- Este procedimiento irá introduciendo nodos el árbol de forma equilibrada o no según el tipo de árbol a partir de una información dada (por ejemplo, una lista)
- Búsqueda de un nodo
- localiza el nodo con el recorrido indicado (inorden, preorden, postorden)
- Inserción de un nodo
- primero localiza dónde insertarlo dependiendo del tipo de árbol.
- Borrado de un nodo
- Dependiendo del tipo de nodo a insertar, si es una hoja o no, y del tipo de árbol, utilizará algoritmos diferentes, ya que en caso de no ser hoja será necesario reequilibrar el árbol.
Usos
- Representar un dato jerárquicamente
- Almacenar un dato de tal modo que su búsqueda sea eficiente (con la búsqueda en árboles binarios)
- Representar listas ordenadas de datos
- Como un flujo de trabajo para la composición de imágenes digitales
- Algoritmos de encaminamiento
Grafos
Introducción histórica
El primer artículo científico relativo a grafos fue escrito por el matemático suizo Leonhard Euler en 1736. Euler se basó en su artículo en el problema de los puentes de Königsberg. La ciudad de Kaliningrado, originalmente Königsberg, es famosa por sus siete puentes que unen ambas márgenes del río Pregel con dos de sus islas. Dos de los puentes unen la isla mayor con la margen oriental y otros dos con la margen occidental. La isla menor está conectada a cada margen por un puente y el séptimo puente une ambas islas. El problema planteaba lo siguiente: ¿es posible dar un paseo comenzando desde cualquiera de estas regiones, pasando por todos los puentes, recorriendo solo una vez cada uno y regresando al mismo punto de partida?
Abstrayendo este problema y planteándolo con la (entonces aún básica) teoría de grafos, Euler consigue demostrar que el grafo asociado al esquema de puentes de Königsberg no tiene solución, es decir, no es posible regresar al vértice de partida sin pasar por alguna arista dos veces.
Definición
Un grafo G {\displaystyle G} G es un par ordenado G = ( V , E ) {\displaystyle G=(V,E)} {\displaystyle G=(V,E)}, donde:
- V es un conjunto de vértices o nodos, y
- E es un conjunto de aristas o arcos, que relacionan estos nodos.
Se llama orden del grafo G a su número de vértices |V|.
El grado de un vértice o nodo v ∈ V es igual al número de arcos que lo tienen como extremo.
Un camino es una secuencia de uno o más arcos que conectan dos nodos. La longitud de un camino es el número de arcos que comprende.
La imagen es una representación del siguiente grafo:
V:={1,2,3,4,5,6}
E:={{1,2},{1,5},{2,3},{2,5},{3,4},{4,5},{4,6}}

Tipos de grafos
Grafos sencillos y múltiples
Un grafo se denomina sencillo si no tiene lazos, es decir, si no existen arcos entre el mismo elemento y no existe más que un arco para unir dos nodos.
Cuando un grafo no es sencillo es múltiple.
Grafos dirigidos y no dirigidos
En un grafo dirigido, un arco es un par ordenado de vértices (v,w) en el cual v es el extremo inicial u origen y w es el extremo final o destino del arco. El arco dirigido (v,w) se representa con una flecha que sale de v y llega a w. Se dice que w es adyacente a v, pero no al revés. La existencia del arco(v,w) no implica la existencia del arco (w,v).
En los grafos no dirigidos, los vértices están relacionados, pero no se apuntan unos a otros. La dirección no es importante. Dos vértices son adyacentes si hay un arco común que los une.
Ejemplos:
- la red de aguas de una población puede ser considerada como un grafo dirigido ya que cada tubería sólo admite que el agua la recorra en un único sentido.
- la red de carreteras interurbanas representa un grafo no dirigido puesto que una misma carretera puede ser recorrida en ambos sentidos.
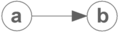
Grafo dirigido
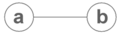
Grafo no dirigido


Grafos conectados y desconectados
En los grafos conectados siempre existe un camino entre cualquier conjunto de vértices.
En los desconectados hay vértices que no están unidos por ningún camino.
Grafos ponderados
En muchas aplicaciones es útil asociar información a los vértices y arcos de un grafo dirigido. Para este propósito es posible usar un grafo dirigido etiquetado, en el cual, cada nodo, cada arco o ambos pueden tener una etiqueta asociada. Una etiqueta puede ser un nombre, un valor, un costo o cualquier tipo de datos dado. Estos grafos también se llaman grafos ponderados o con peso.
Representación de los grafos
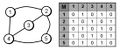
Matriz de adyacencia

Listas de adyacencia


Matriz de adyacencia
Si G es un grafo dirigido de n nodos, el grafo G lo representaremos por una matriz N x N tal que G[i,j]=0 si no existe un arco entre el nodo i y el nodo j, y 1 (o el peso del arco en caso de tenerlo) si existe el arco.
Esta representación es tremendamente sencilla, pero tiene la limitación del uso de una estructura estática de datos, por lo que el número de nodos va a estar limitado.
Listas de adyacencia
Otras representaciones más generales están basadas en la utilización de punteros. Una estructura que representa un grafo adecuadamente es una lista de listas.
En la lista principal se encuentran todos los nodos de G. Cada nodo de esta lista tiene asociada una lista auxiliar donde se indican los nodos que están conectados a él (que son adyacentes)
Operaciones
Las operaciones que puede incluir un grafo son muy variadas y dependerán del problema que queramos abordar.
Además de las clásicas de búsqueda de un elemento, inserción o eliminación de un nodo o arco, también podemos encontrarnos con:
- ejecución de algoritmos que busquen caminos más cortos entre dos vértices
- recorridos del grafo que ejecuten alguna operación sobre todos los vértices visitados,
- ...
Estructuras de datos en algunos lenguajes de programación
Java
Java incluye un conjunto de interfaces y clases genéricas, conocido como el Java Collection Framework (marco de trabajo de colecciones de Java), el cual contiene estructuras de datos, interfaces y algoritmos pre empaquetados para manipular estructuras de datos tales como listas, pilas, colas, conjuntos y mapas clave – valor.

Mapas

Colecciones: lista, cola y conjunto
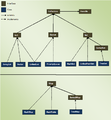
Jeraraquía de colecciones (visión simplificada)


El marco de trabajo de colecciones de Java proporciona componentes reutilizables, listos para utilizarse; los programadores utilizan las estructuras de datos existentes sin tener que preocuparse por la manera en que éstas se implementan.
| Interfaz | Descripción |
|---|---|
| Collection | La interfaz raíz en la jerarquía de colecciones, a partir de la cual se derivan las interfaces Set, Queue y List. |
| Set | Una colección que no contiene duplicados. |
| List | Una colección ordenada que puede contener elementos duplicados. |
| Map | Asocia claves con valores y no puede contener claves duplicadas. |
| Queue | Por lo general, una colección del tipo primero en entrar, primero en salir, que modela a una línea de espera; pueden especificarse otros órdenes. |
Las interfaces del marco de trabajo de colecciones declaran las operaciones que se deben realizar en forma genérica en varios tipos de colecciones
Estas clases proporcionan métodos eficientes que organizan, almacenar y recuperar sus datos sin necesidad de conocimientos de cómo se almacenan los datos. Esto reduce el tiempo de desarrollo de aplicaciones.
Ejemplo
 1  import java.util.*;
 2  public class ArrayListExample {
 3    public static void main(String args[]) {
 4     //Creación de una lista ArrayList de elementos de tipo String
 5     ArrayList<String> lista = new ArrayList<String>();
 6
 7     //Adición de elementos a la lista
 8     lista.add("Juan");
 9     System.out.println("La lista actual es:"+lista);
10    }
11  }
Extensiones
El framework Java collections se puede extender con la librería Apache Commons Collections que añade tipos de coleciones como el mapa bidreccional, la bolsa o utilidades para crear uniones e intersecciones
Google tiene us propias librearías de collections como parte de las librerías guava.
Python
En Python hai por defecto catro tipos de datos para almacenar coleccións de datos:
- A lista é una colección que pode ser ordeada e cambiable; permite duplicados.
- A tupla é unha colección que pode ser ordeada e non cambiable; permite duplicados.
- O conxunto é unha colección que non pode ser ordeada nin ten un índice; non permite duplicados
- O diccionario é unha colección que pode ser ordeada e cambiable; non permite duplicados
É importante coñecer as propiedades de cada tipo de colección para escoller a máis axeitada, facilitando a mellor comprensión e un incremento do rendemento e da seguridade.
Exemplos
1  # exemplos
2  lista    = ["pera", "banana", "cereixa"]
3  tupla    = ("pera", "banana", "cereixa")
4  conxunto = {"pera", "banana", "cereixa"}
5  dicionario = {
6   "marca": "Ford",
7   "modelo": "Mustang",
8   "ano": 1965
9  }
Conclusiones
Según el autor J. Glenn Brookshear, en su libro "Introducción a la computación" (2012), una ventaja de las estructuras estáticas es que son más fáciles de manejar, ya que las estructuras dinámicas tienen que llevar a cabo varias tareas adicionales, como, por ejemplo, buscar bloques de memoria libres, lo que afecta al rendimiento. Por el contrario, las estructuras dinámicas son más versátiles, ya que no siempre se conoce previamente el número de elementos que se van a procesar.
Programar eficazmente implica elegir un tipo de estructura adecuada de datos a la tarea que se desea programar. Es necesario indicar que la distinción entre estructuras estáticas y dinámicas es sólo aplicable a los lenguajes de programación compilados, mientras que, en los lenguajes interpretados, como por ejemplo PHP, los vectores pueden crecer de forma dinámica, o como en Java, el tamaño de los vectores se puede determinar en tiempo de ejecución, ya que en estos lenguajes se implementa un método de reserva dinámica de memoria, aplicable a cualquier tipo de dato compuesto.
Relación con el currículo
Este tema es aplicado en el aula en los módulos profesionales siguientes, con las atribuciones docentes indicadas (PES/SAI): Grado Superior
- Lenguajes de Marcas y Sistemas de Gestión de la Información (DAW - DAM -ASIR) (PES)
- Programación (DAW / DAM) (PES)
- Entornos de desarrollo: (DAW / DAM) (PES)
ESO y Bachiller
- Tecnologías de la Información y la Comunicación I (PES)
- Tecnologías de la Información y la Comunicación II (PES)
- Programación y computación (libre configuración autonómica) (PES)
Bibliografía
- Y. Daniel Liang. , Introduction to Java Programming and Data Structures, Comprehensive Versión. Pearson, 11ª edición. 2017.
- Francisco Javier Moldes Teo. , Java 9. Anaya. 2017.
- J, Glenn Brookshear, Introducción a la computación. Edt. Pearson, 11º edición. 2012
- Luis Joyanes Aguilar , Fundamentos de programación. Algoritmos, estructuras de datos y objetos., McGraw-Hill, 4º edición. 2008.
- Langsam, Augenstein y Tanembaum: "Estructuras de Datos con C y C++", Prentice-Hall 1997
- Prieto A., Lloris A. y Torres J.C.: Introducción a la Informática, McGraw-Hill, 4ª ed 2010
Referencias
- Diagramas de Venn
- El TAD de los conjuntos
- Introducción a los TDA
- Tipo de dato abstracto
- Los Tipos Abstractos de Datos
- Árbol
- Curso de introducción a las estructuras de datos
