Diferencia entre revisiones de «Organización lógica de los datos. Estructuras dinámicas.»
| Línea 272: | Línea 272: | ||
=== Operaciones === | === Operaciones === | ||
| + | |||
| + | === Usos === | ||
| + | * Representar un dato jerárquicamente | ||
| + | * Almacenar un dato de tal modo que su búsqueda sea eficiente (con la búsqueda en árboles binarios) | ||
| + | * Representar listas ordenadas de datos | ||
| + | * Como un flujo de trabajo para la composición de imágenes digitales | ||
| + | * Algoritmos de encaminamiento | ||
== Grafos == | == Grafos == | ||
Revisión del 03:09 5 may 2021
Sumario
Introducción
La información en la sociedad actual es un aspecto relevante en múltiples ramas del conocimiento; incluyendo la biología genética, la física cuántica, la divulgación científica y por supuesto la informática, Internet y el tratamiento de la información.
Cada día, se intercambian unos 2,5 billones de bytes de datos. Se estima que el 90% de los datos existentes en el mundo actual se han generado en el curso de los últimos dos años. Este diluvio se conoce como Big Data.
Sin embargo, este tremendo gigante en el que se apoya la sociedad moderna, requiere de estructuras de datos y programas que los manipulen de forma eficiente.
Según el autor Y. Daniel Liang, en su libro Introduction to Java Programming and Data Structures, Comprehensive Versión (2017), "elegir la estructura de datos más adecuada es, junto con el diseño del algoritmo, la clave para desarrollar software con un buen rendimiento".
Organización Lógica de los Datos
Descripción de datos
Un dato puede identificarse:
- de forma directa dando su valor
- asignándole un nombre con el que vamos a reconocer ese dato
Hay que ver también si ese valor va a mantener fijo su valor a lo largo del problema o bien se va a mantener constante durante todo el proceso, podemos por tanto encontrar datos literales y asociados a un identificador.
- Literales
- Es la expresión de un valor de un tipo de dato. Por ejemplo, son literales "nombre", 5, 'a'. Son, por tanto, valores fijos.
- Variables
- Representa un conjunto de posiciones de memoria que tienen asociado un nombre (identificador) y un valor (contenido) de un determinado tipo. Para utilizar una variable normalmente hay que declararla primero, asignándole un nombre y un tipo de dato.
- Constantes
- Es un dato cuyo valor se declara al principio del programa y no variará a lo largo del algoritmo. Igual que las variables se asocia un nombre al valor de la constante.
Tipos de datos
Tipos simples y compuestos
Los tipos de datos utilizados en los diferentes lenguajes de programación se pueden clasificar en tipos simples y en tipos compuestos.
Los tipos de datos simples o primitivos no están compuestos de otras estructuras de datos. Los usados más frecuentemente en casi todos los lenguajes son: enteros, reales o carácter. Los datos simples tienen como característica común que cada variable representa a un elemento.
Los tipos de datos compuestos o estructurados de datos están construidos basándose en tipos de datos simples. El ejemplo más representativo es la cadena de caracteres. Los datos estructurados tienen como característica común que un identificador puede representar a múltiples datos individuales, pudiendo estos ser referenciados individualmente.
Las estructuras de datos se pueden dividir según su modo de almacenamiento en:
- Externas
- Se almacenan en la memoria externa del ordenador: ficheros y bases de datos.
- Internas
- Se almacenan en memoria interna
Las estructuras de datos internas pueden a su vez clasificarse en:
- Estáticas
- El tamaño ocupado en la memoria se define antes de que el programa se ejecute y no puede modificarse durante la ejecución del programa. Están implementadas en casi todos los lenguajes y son los registros, ficheros y matrices. Dependiendo del tipo de dato pueden ser:
- Homogéneas
- todos los subelementos son del mismo tipo: arrays o matrices
- Heterogéneas
- los subelementos contienen datos de distintos tipos: registros
- Dinámicas
- El tamaño de la estructura se va modificando conforme avanza el programa; es decir, su tamaño cambia en tiempo de ejecución.
- Lineales
- listas, pilas, colas
- No lineales
- árboles y grafos
- Punteros
- Los tipos de datos puntero a apuntadores almacenan direcciones de memoria que a su vez indican la posición de otras estructuras de datos o funciones del programa.
El siguiente esquema muestra una clasificación de los tipos de datos más comunes:

TDA - Tipo de dato abstracto
Muy relacionado está también el concepto de tipo de dato abstracto (TDA) o Abstract Data Type que fue propuesto por primera vez hacia 1974 por John Guttag y otros, pero no fue hasta 1975 que por primera vez Barbara Liskov lo propuso para el lenguaje CLU.
Es un modelo matemático compuesto por una colección de operaciones definidas sobre un conjunto de datos para el modelo (Por ejemplo, el TDA "Cadena").
TAD = valores + operaciones
Especificación
Se debe:
- Establecer la interfaz con el usuario del tipo (“lo que necesita saber el usuario”)
- Decir qué es sin decir nada sobre cómo se hace
- Se trata de dar la lista de operaciones necesarias y especificarlas
- Debe ser precisa, legible y no ambigua

Implementación
- Elegir la representación de los valores
- Implementar las operaciones
- Debe ser estructurada, legible y eficiente
- Una propiedad deseable es la encapsulación
- Representación privada: el usuario no conoce los detalles de la implementación
- Tipo protegido: El usuario sólo puede utilizar las operaciones previstas

Ventajas y desventajas de las estructuras de datos estáticas/dinámicas
Según el autor J. Glenn Brookshear, en su libro "Introducción a la computación" (2012):
- una ventaja de las estructuras estáticas es que son más fáciles de manejar, ya que las estructuras dinámicas tienen que llevar a cabo varias tareas adicionales, como, por ejemplo, buscar bloques de memoria libres, lo que afecta al rendimiento.
- Por el contrario, las estructuras dinámicas son más versátiles, ya que no siempre se conoce previamente el número de elementos que se van a procesar.
Estructuras Dinámicas
Pilas
Una pila es una estructura de datos que tiene principalmente dos operaciones apilar y desapilar. Es un tipo de estructura que sigue un patrón LIFO (Last in, First out) Es decir el último elemento que insertemos (apilar) será el primero en salir (desapilar)

Usos
Algunos usos:
- Podemos implementar la acción deshacer
- Podemos implementar la búsqueda en profundidad ()
- Podemos evaluar la sintaxis de una calculadora los () y los {}
- Podemos guardar las llamadas de las funciones recursivas en el orden en que se tienen que ir ejecutando
Operaciones
- Crear una pila
- Apilar (push)
- Desapilar (pop)
- Ver la cima (peek)
- Tamaño
- ¿Está vacía?
Implementaciones
Implementación de una pila con una lista ligada
- CREAR
- Se inicializará una lista ligada.
- APILAR
- Se utilizará el método insertar al inicio
- DESAPILAR
- Se utilizará el método sacar del principio.Este método quita el elemento de la lista
- VER LA CIMA
- Se utilizará el método para ver el primer elemento de la lista ligada
| Función | Coste |
|---|---|
| Apilar | O(1) |
| Desapilar | O(1) |
| Ver la cima | O(1) |
Ejemplo
- Cremos pila.
- Apilamos en este orden: C, B y A
- Desapilamos en este orden: A

Creamos Pila

Apilamos C

Apilamos B

Apilamos A
Desapilamos A

Desapilamos B


Implementación de una pila con un Array dinámico
- CREAR
- Se iniciará un array dinámico. Puede tener un tamaño inicial por ejemplo de 5. Tendrá una variable para indicar la cima que llamaremos top y estará inicializada con -1
- APILAR
- Se utilizará la variable de tamaño para saber cual es la parte donde tiene que insertarlo
top++
arrayInterno[top] = objeto
- DESAPILAR
- Solo será necesario indicar que el top es una unidad más pequeña, para que en el siguiente apilamiento sobreescriba el dato
- VER LA CIMA
- Cogeremos el valor que este en la posicion top de del array interno
| Función | Coste |
|---|---|
| Apilar | O(1) |
| Desapilar | O(1) |
| Ver la cima | O(1) |
Ejemplo
- Creamos pila.
- Apilamos en este orden: A y B
- Desapilamos en este orden: B
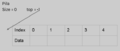
Creamos pila

Apilamos A
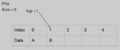
Apilamos B

Desapilamos B


Colas
Una cola es una estructura de datos que tiene principalmente dos operaciones encolar y desencolar. Es un tipo de estructura que sigue un patrón FIFO (First in, First out) Es decir el primer elemento que insertemos (encolar) será el primero en salir (desencolar).

Usos
- Sirve para transferir datos entre procesos asíncronos
- En un servidor podemos implementar una cola para la venta de entradas
- Nos sirve para implementar la búsqueda en anchura
Operaciones
- Crear una cola
- Encolar (Enqueue)
- Desencolar (Dequeue)
- Ver el frente (peek)
- Tamaño
- ¿Está vacía?
Implementación con una lista ligada
Implementación de una pila con una lista ligada
- CREAR
- Se inicializará una lista ligada.
- ENCOLAR
- Se utilizará el método insertar al final
- DESENCOLAR
- Se utilizará el método sacar al principio. Este método quita el elemento de la cola
- VER EL FRENTE
- Se utilizará el método para ver el primer elemento de la lista ligada
| Función | Coste |
|---|---|
| Encolar | O(1) |
| Desencolar | O(1) |
| Ver el frente | O(1) |
Ejemplo
Ejemplo
- Cremos pila.
- Encolamos en este orden: A, B y C
- Dessencolamos en este orden: A y B
Creamos Cola

Encolamos A

Encolamos B

Encolamos C

Desencolamos A

Desencolamos B


Listas
Definición
Declaración
Estructura
Operaciones
Árboles
Definición
Estructura
Tipos de árboles
Almacenamiento en memoria
Operaciones
Usos
- Representar un dato jerárquicamente
- Almacenar un dato de tal modo que su búsqueda sea eficiente (con la búsqueda en árboles binarios)
- Representar listas ordenadas de datos
- Como un flujo de trabajo para la composición de imágenes digitales
- Algoritmos de encaminamiento
Grafos
Definición
Tipos de grafos
Representación de los grafos
Operaciones
Conclusiones
Según el autor J. Glenn Brookshear, en su libro "Introducción a la computación" (2012), una ventaja de las estructuras estáticas es que son más fáciles de manejar, ya que las estructuras dinámicas tienen que llevar a cabo varias tareas adicionales, como, por ejemplo, buscar bloques de memoria libres, lo que afecta al rendimiento. Por el contrario, las estructuras dinámicas son más versátiles, ya que no siempre se conoce previamente el número de elementos que se van a procesar.
Programar eficazmente implica elegir un tipo de estructura adecuada de datos a la tarea que se desea programar. Es necesario indicar que la distinción entre estructuras estáticas y dinámicas es sólo aplicable a los lenguajes de programación compilados, mientras que, en los lenguajes interpretados, como por ejemplo PHP, los vectores pueden crecer de forma dinámica, o como en Java, el tamaño de los vectores se puede determinar en tiempo de ejecución, ya que en estos lenguajes se implementa un método de reserva dinámica de memoria, aplicable a cualquier tipo de dato compuesto.
Relación con el currículo
Este tema es aplicado en el aula en los módulos profesionales siguientes, con las atribuciones docentes indicadas (PES/SAI): Grado Superior
- Lenguajes de Marcas y Sistemas de Gestión de la Información (DAW - DAM -ASIR) (PES)
- Programación (DAW / DAM) (PES)
- Entornos de desarrollo: (DAW / DAM) (PES)
ESO y Bachiller
- Tecnologías de la Información y la Comunicación I (PES)
- Tecnologías de la Información y la Comunicación II (PES)
- Programación y computación (libre configuración autonómica) (PES)
Bibliografía
- Y. Daniel Liang. , Introduction to Java Programming and Data Structures, Comprehensive Versión. Pearson, 11ª edición. 2017.
- Francisco Javier Moldes Teo. , Java 9. Anaya. 2017.
- J, Glenn Brookshear, Introducción a la computación. Edt. Pearson, 11º edición. 2012
- Luis Joyanes Aguilar , Fundamentos de programación. Algoritmos, estructuras de datos y objetos., McGraw-Hill, 4º edición. 2008.
- Langsam, Augenstein y Tanembaum: "Estructuras de Datos con C y C++", Prentice-Hall 1997
- Prieto A., Lloris A. y Torres J.C.: Introducción a la Informática, McGraw-Hill, 4ª ed 2010
